跳转至内容
  • 门户首页
  • 聊天室
  • 最新
  • 热门
  • 版块
  • 关于
    • 隐私政策
    • 使用条款
皮肤
  • 浅色
  • 深色

折叠
品牌标识

administrators

私有

帖子


  • AirLLM:单卡 4GB 跑 70B,把显存从「装下模型」改成「装下一层」
    A admin
    前沿技术&Advanced Technology

    核心判断

    AirLLM(仓库 lyogavin/airllm)解决的是一个被多数推理库放弃的问题:在 4-8GB 显存的消费级硬件上,跑起 70B 甚至 405B、671B 参数的原始权重模型。它走的是"分时换入"这条路——平时只把当前正在计算的那一层参数读进显存,其余层在 NVMe/SSD 上待机,算完即弃,下一层顶上。 AirLLM(仓库 lyogavin/airllm)解决的是一个被多数推理库放弃的问题:在 4-8GB 显存的消费级硬件上,跑起 70B 甚至 405B、671B 参数的原始权重模型。它走的是"分时换入"这条路——平时只把当前正在计算的那一层参数读进显存,其余层在 NVMe/SSD 上待机,算完即弃,下一层顶上。


  • Markdown和WYSIWYG富文本编辑器的最佳形态 做好自己 做好自己
    rootbeerR rootbeer
    前沿技术&Advanced Technology

    @admin not bad


  • AirLLM:单卡 4GB 跑 70B,把显存从「装下模型」改成「装下一层」
    A admin
    前沿技术&Advanced Technology

    45e9e0e79f370442702f37101e69bb4d.jpg
    核心判断
    AirLLM(仓库 lyogavin/airllm)解决的是一个被多数推理库放弃的问题:在 4-8GB 显存的消费级硬件上,跑起 70B 甚至 405B、671B 参数的原始权重模型。它走的是"分时换入"这条路——平时只把当前正在计算的那一层参数读进显存,其余层在 NVMe/SSD 上待机,算完即弃,下一层顶上。

    这条路换来了几件别家没同时做到的事:

    4GB VRAM 跑 70B:不量化、不蒸馏、不剪枝,权重保持原始 fp16/bf16 精度
    8GB VRAM 跑 405B Llama3.1:405B 的权重在 fp16 下约 810GB、fp8 下也要约 405GB——原本得在多张高端 GPU 上才能稳住推理,AirLLM 把它压到单卡 8GB
    约 12GB 跑 DeepSeek-V3(671B)、约 3GB 跑 Qwen3-235B:v3.0 起,稀疏 MoE 模型不再整层加载,改为单个 token 实际路由到的专家逐个流式加载
    2026-07 更进一步,官方称 Kimi K3(2.8T,当时开源的最大模型)在单张 RTX 6000 Ada 上实测约 3.72GB 显存跑通。

    代价同样明确。逐层换入意味着每生成一个 token 都要把模型层从磁盘读一遍,吞吐低。AirLLM 的定位是"单卡 / 边缘设备能跑起来",对应个人研究、论文复现、边缘 demo 这类对延迟不敏感、对显存极度敏感的场景;高 QPS 服务请直接走 vLLM / TensorRT-LLM。

    下文先给项目地图和一条总览,再拆解分层加载、块级量化、预取、稀疏 MoE 四条机制的边界,用一个 70B 推理的完整任务流把机制串起来,然后解读性能数字的测量范围,最后给上手示例、常见问题和采用决策。读完后,你应当能独立判断一件事:在什么样的模型规模、显存大小和延迟要求下,AirLLM 才是对的选择,而不是顺手就用。

    项目地图
    维度 关键信息
    仓库 lyogavin/airllm
    PyPI pypi.org/project/airllm
    许可证 Apache-2.0
    Stars / Forks 29,485 / 3,150(GitHub API,2026-08-07 验证)
    主语言 Jupyter Notebook(推理内核为 PyTorch)
    定位 4GB 单卡跑 70B(仓库官方描述)
    版本里程碑
    时间 事件
    2023-11 AirLLM 初始版本
    2023-12 v2.0:块级量化压缩,官方称最高 3x 加速
    2023-12 补 safetensors + ChatGLM / QWen / Baichuan / Mistral / InternLM 支持
    2023-12 v2.5:预取(prefetching)重叠加载与计算
    2023-12 v2.6:AutoModel 自动识别模型类型;v2.7:Mixtral
    2023-12 v2.8.2:macOS 跑 70B
    2024-04 Llama3 70B 在 4GB 单卡原生支持
    2024-07 Llama3.1 405B 在 8GB VRAM + 8bit/4bit 量化
    2024-08 v2.10:CPU 推理;v2.11:Qwen2.5
    2026-06 v3.0:FP8 支持,DeepSeek-V3(671B)约 12GB、Qwen3-235B 约 3GB
    2026-07 Kimi K3(2.8T)单卡约 3.72GB 跑通
    机制总览:四条主线各管一段
    AirLLM 的低显存能力来自三条相互独立、可单独开关的机制,加上 v3.0 对稀疏 MoE 的第四条专用路径。理解它们的边界,才能判断该不该开、开哪条、开了换什么。

    机制 换什么 主要瓶颈 何时开
    分层加载 用时间换显存 磁盘 IO 带宽 默认开,无法关
    块级量化 用精度换 IO 带宽 反量化计算开销 磁盘是瓶颈时开
    预取 用线程换延迟 后台线程调度 计算和 IO 可比时开
    稀疏 MoE 逐专家加载 用路由换显存 专家调度开销 v3.0 起,MoE 模型默认走
    工作原理:四条机制如何配合
    分层加载:用时间换显存
    大模型推理的本质是逐层矩阵乘法。第 N 层的输出是第 N+1 层的输入,任意时刻只有一层的权重真正参与计算。AirLLM 利用这一点,把整个模型按层切分成 shard 文件存放在磁盘上,推理时只把当前层读进显存,算完立即释放,再读下一层。

    这样做的代价是显存占用从"全部权重"降到"单层权重 + KV cache + 激活"。70B 模型 fp16 全量约 140GB,单层 transformer block 权重约 1.7GB(Llama 3 70B 约 80 层),加上 KV cache 和中间激活,4GB 显存仍能容纳。代价是每生成一个 token,都要把全部 80 层从磁盘读一遍,IO 成为吞吐瓶颈。

    为什么这条路在 70B 上可行、在 7B 上反而没必要?因为 7B 模型全量 fp16 只有 14GB,24GB 显卡能整体装下,走标准 transformers 推理比逐层换入快一个数量级。分层加载的价值随模型规模放大——模型越大,全量装载越不现实,逐层换入的相对代价越可接受。

    块级量化:用精度换磁盘带宽
    分层加载的瓶颈在磁盘 IO 一侧,计算端通常有余。块级量化(block-wise quantization)针对的就是这个瓶颈:把权重从 fp16 压到 4bit 或 8bit,磁盘读取量直接减半或减到四分之一,IO 时间相应缩短。

    AirLLM 的块级量化有两个设计选择:

    只压权重,不压激活。激活值在推理时动态产生,量化会引入误差累积;权重是静态的,可以离线量化好存盘。这种不对称让精度损失主要来自权重 round-to-nearest,可控且可预测。
    按 block 量化,不是按 tensor 量化。把权重张量切成小块(block),每块独立计算 scale 和 zero point。相比全 tensor 量化,block 量化能更好适应权重数值分布的局部差异,精度损失更小。
    官方称 4bit 量化带来最高约 3x 加速。这个数字主要反映 IO 时间缩短——磁盘读取量降到四分之一,加上反量化开销,净加速约 3 倍。它不反映计算加速,因为反量化后实际计算仍在 fp16/bf16 进行。官方把这套 block-wise 量化方案指向了论文 arXiv:2212.09720。

    预取:用线程换延迟
    分层加载的朴素实现是串行的:读层 N → 计算 → 释放 → 读层 N+1 → 计算。预取(prefetching)用一个后台线程,在层 N 计算的同时把层 N+1 的权重读进显存,计算和 IO 重叠。

    官方在 v2.5 加入预取时称带来约 10% 的速度提升。它有效的前提是计算时间和 IO 时间可比——如果计算极快(小 batch、短序列),预取线程来不及读完下一层,加速有限;如果 IO 极快(NVMe RAID、内存盘),预取本身就成了多余开销。README 注明目前只有 AirLLMLlama2 支持预取。

    稀疏 MoE:逐专家流式加载(v3.0)
    MoE 模型(如 DeepSeek-V3、Qwen3-235B)的每一层并不全量参与计算,而是由路由网络为每个 token 挑出少数几个专家。v3.0 据此把"整层加载"改成"只加载被路由到的专家"——单个 token 实际用到的专家数远小于层内专家总数,显存占用随之骤减。这也是 671B 的 DeepSeek-V3 能压到约 12GB、235B 的 Qwen3 能压到约 3GB 的原因。

    总览表里那四条,作用在流水线的不同阶段:分层加载决定显存上限,块级量化决定 IO 时间,预取决定 IO 与计算的重叠程度,稀疏 MoE 进一步压掉未参与计算的专家。它们可以独立调参,但效果上限受最弱一环制约——开了 4bit 量化后若磁盘仍是瓶颈,预取收益就有限。

    一次推理如何流过系统
    以 70B 模型生成 20 个 token 为例,假设 4bit 量化 + 预取开启,跟踪一次完整推理的流程:

    模型加载阶段(首次启动耗时较长,取决于磁盘与网络):AutoModel.from_pretrained 下载原始权重,按层切分成 shard 文件写入 HF cache 目录。README 提醒切分过程非常耗磁盘空间,需保证 cache 目录有足够空间。70B 4bit 量化后磁盘占用约 35GB。
    prompt 编码:tokenizer 把输入文本转成 token ids,放进显存的 KV cache 槽位。这一步在 GPU 上完成,不涉及权重读取。
    第一个 token 生成(prefill 阶段):
    主线程读取 layer 0 权重到显存,计算 attention + FFN,输出传给 layer 1
    后台预取线程同时读取 layer 1 权重
    layer 0 计算完毕,释放显存,主线程拿预取好的 layer 1 开始计算
    后台预取线程转去读 layer 2
    如此推进 80 层,最后一层输出经 lm_head 得到第一个 token
    后续 token 生成(decode 阶段):每个新 token 都要重走一遍 80 层,区别是 KV cache 已经存了历史 token 的 K/V,attention 计算量随序列长度增长。每个 token 都触发一次完整的 80 层磁盘读取。
    20 个 token 完成:总耗时约 4-6 秒(社区报告值),其中 IO 占大头,计算占比随序列长度上升。
    这个流程里有一个反直觉的细节:生成长序列时,AirLLM 的单 token 延迟会随序列变长而上升,因为 attention 计算量在增长,而 IO 时间基本恒定。这与 vLLM 等 batch 推理引擎的行为相反——后者主要受 batch 大小影响。

    性能特征:数字在测什么
    社区报告的"70B 4-6 秒 / 20 token"主要测的是单请求 decode 阶段的端到端延迟,包含磁盘 IO + 计算 + 反量化开销。它反映的是 AirLLM 在消费级硬件(NVMe + 4-8GB 显卡)上的典型表现。

    从这些数字里能推出什么:

    AirLLM 适合交互式或离线场景,单次生成几十到几百 token 可接受
    4bit 量化相对 fp16 的精度损失在多数生成任务上不显著(weight-only 量化的 perplexity 上升通常在个位数百分比,具体数值因模型和量化方案而异)
    从这些数字里不能推出什么:

    不能推出 batch 推理性能。AirLLM 的设计不支持 batch > 1 的高效推理,因为每层都要为 batch 中每个样本读权重,IO 放大严重
    不能推出与 vLLM 的直接对比。vLLM 测的是吞吐(token/s over batch),AirLLM 测的是单请求延迟,两者不在同一坐标轴
    不能推出生产可用性。4-6 秒 / 20 token 折合约 3-5 token/s,远低于生产级 chat 服务的延迟要求
    快速上手


  • Markdown和WYSIWYG富文本编辑器的最佳形态 做好自己 做好自己
    A admin
    前沿技术&Advanced Technology

    对于一个创作平台而言,一款好用的Web富文本编辑器是至关重要的,对目前市面上的Web版的富文本编辑器作了一番研究,发现目前Web编辑器主要集中在两种类型: Markdown编辑器和WYSIWYG(所见即所得)编辑器, 两者之争由来已久。下面简要说说两者的优缺点:
    viral-referral.png

    Markdown

    优点:

    专注你的文字内容而不是排版样式,专心写作,这也是Markdown被设计出来的初衷,这对于从vi/vim过来的人来说有种天然的亲切感,同样是书写时手不碰鼠标。
    纯文本内容,兼容所有的文本编辑器软件。
    可以随时修改你的文章。
    可读、直观、学习成本低。
    轻松的导出 HTML、PDF 和本身的 .md 文件,有许多高质量的库可供选择。
    缺点:

    Markdown是扁平结构的,这也导致了Markdown的表现力不够丰富。无法实现精细的排版。
    Markdown的标准不一。由于Markdown基本标准支持的格式有限,所以出现了很多不同的扩展,这些扩展没有统一的标准,这导致了兼容性成为问题。
    Markdown不是所见即所得的,Markdown需要渲染后才可被真正阅读。
    对于写技术文档、备忘录、笔记等就非常适合用Markdown来书写和预览,因为这些注重内容不注重排版。

    我个人有写笔记的习惯,我使用VS Code内置的Markdown编辑器来书写和预览我的所有个人文档。

    WYSIWYG(所见即所得)编辑器

    优点:

    表现力丰富,可实现复杂的排版,Web版的MS Office Word就是一个WYSIWYG(所见即所得)编辑器。
    所见即所得,编辑时和阅读时可以做到一致。
    缺点:

    全功能的编辑器实现难度大。
    后端存储的字节数比markdown大很多。
    书写和排版通常分成两个步骤,通常是先书写后统一排版。

    上面分析了Markdown和WYSIWYG编辑器的优缺点,下面分析一下编辑器的选型问题:

    首先,选择何种编辑器需要考虑你的平台的受众人群,如果是IT技术人员为主的,采用Markdown编辑器合适。但如果是知乎这类面向普罗大众的创作平台,那么只使用Markdown编辑器就不合适了。因此,知乎的文章编辑器选择了WYSIWYG富文本编辑器,我想它是做了分析与权衡的,从它的产品定位和平台受众来说,它的选择是正确的。

    有些创作平台使用了双编辑器,书写文章时可以选择Markdown编辑器或富文本编辑,但这并不完美。难道选择了富文本编辑器, 我就不能在其中使用Markdown?

    知乎的文章编辑器在这方面作了一番努力,它称之为Markdown语法识别,使得书写体验尽可能的接近Markdown,不幸的是,它没有做到最佳。目前知乎的编辑器存在的问题:

    不支持从Markdown中直接复制粘贴,需要导入文件的形式来兼容Markdown。这对需要从多个Markdown文档中复制部分内容到一篇文章中那简直是灾难,这也是知乎编辑器最大的问题。
    支持数学公式,但不支持行内数学公式,这对于数学专业的文章来说排版是个问题。块级数学公式不能居中。
    不支持文本删除线
    不支持任务列表
    不支持上标和下标
    不支持文本对齐
    表格不支持单元格合并和拆分,不支持手动调整列宽,表格单元格输入有bug,经常新行的单元格中输入时会丢失游标。
    表格不支持嵌套
    想要输入+ xxx,- xxx,* xxx 麻烦的要死,因为它会强行识别为列表,可有时我就想输入这些文本,不信你可以自己去试试, 其它语法识别也一样,它没有一种使你可以快速放弃转换的操作。
    罗列了这么多知乎编辑器的不足之处,知乎的文章编辑器又不开源,想帮它优化也没办法。

    于是我决定参考知乎的文章编辑器的功能自己研发一套Web富文本编辑器,我的目标是:采用WYSIWYG富文本模式,这样适用性更广,吸收知乎的文章编辑器的所有优点,同时要支持从Markdown内容中直接粘贴,输入时支持Mardown语法识别。目前已经开发完成,我都还没有为它取好名,广大网友也可以帮我取个名。


  • 中国历史名校(图)
    A admin
    互动博客InteractiveBlogs

    前段时间满屏都中国籍学者王虹和邓煜获得数学界的最高荣誉的菲尔兹奖(Fields Medal)的新闻。不过中国籍数学家好像并不一定就是中国数学家吧。


  • 中国历史名校(图)
    A admin
    互动博客InteractiveBlogs

    前段时间满屏都中国籍学者王虹和邓煜获得数学界的最高荣誉的菲尔兹奖(Fields Medal)的新闻。不过中国籍数学家好像并不一定就是中国数学家吧。

    因为邓煜在北大只读了两年本科,随后转学至美国麻省理工学院(MIT),之后获得普林斯顿大学博士学位,目前担任美国芝加哥大学数学系教授。

    29a1599389965UjsN0Y9.jpg

    王虹本科最初就读于北京大学地球与空间科学学院,大二转入数学科学学院。她曾公开提到,自己当时成绩处于中下游,一度感到比较受挫,后来保研和直博都没有成功。此后,她赴法国巴黎综合理工学院攻读硕士,又在美国麻省理工学院获得博士学位,现为法国高等科学研究所终身教授。

    虽然王虹和邓煜都曾是北京大学数学科学学院2007级本科生,北大是他们学术道路的重要起点,但两人真正奠定国际数学成就的培养和科研阶段,主要是在欧美高校和科研机构完成的,跟北大的教育培养有多大的关系?
    29a159939447Q52ibgBO.jpg

    (网图)

    北京大学是中国最顶尖的大学之一,也是世界知名的综合性大学。北大创办于1898年,历史悠久,拥有深厚的人文、科学和社会科学传统。“思想自由、兼容并包”的精神也一直影响着中国现代大学。多年前曾参观过燕园,印象深刻。

    这些年随着中国经济的发展,不少重点大学都在朝着“世界一流大学”的目标迈进,很多人有名校情结。但一所真正的世界一流大学,靠的不只是漂亮的校园、先进的实验室和一流的硬件设施,更重要的是拥有顶尖的学者,营造鼓励创新、尊重学术自由、宽容不同观点的学术环境和大学精神。

    早在民国时期,中国就有过几所享誉国际的一流大学,而大名鼎鼎的中国历史上第一所大学圣约翰大学(Saint John’s University)就是其中之一。

    圣约翰大学以高度国际化的教育理念和鲜明的职业导向享有盛誉。它的影响力不仅遍及上海和全国,在欧美也颇有知名度。圣约翰大学还曾被誉为近代中国的“外交家的摇篮”“东方剑桥”和“东方哈佛”。

    29a159939626789O0SAi.jpg
    (网图)

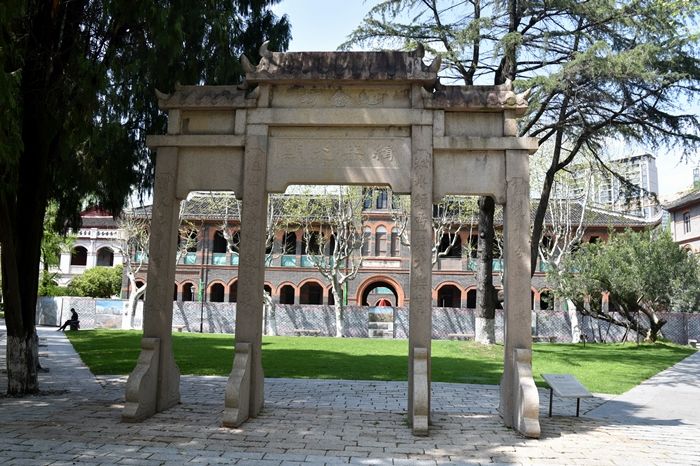
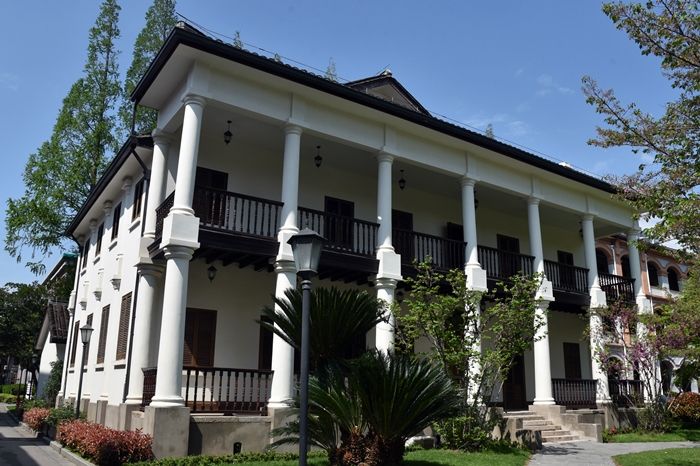
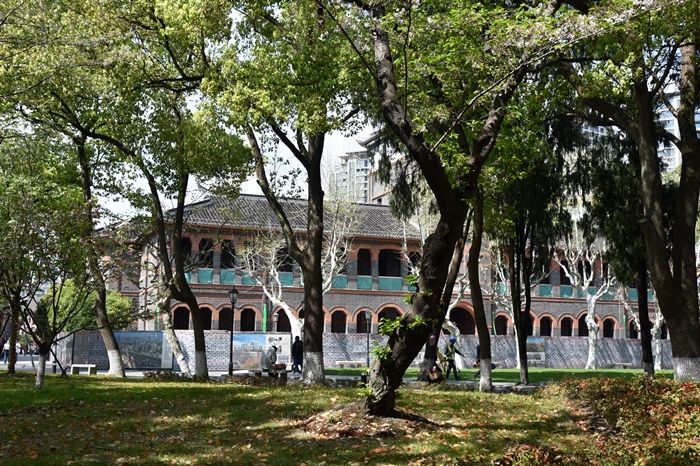
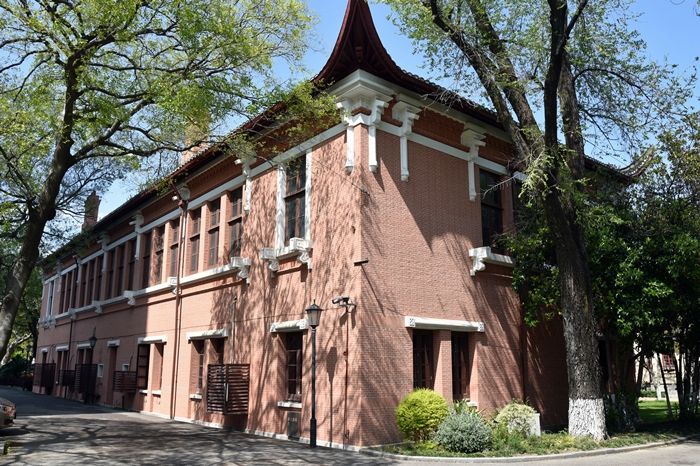
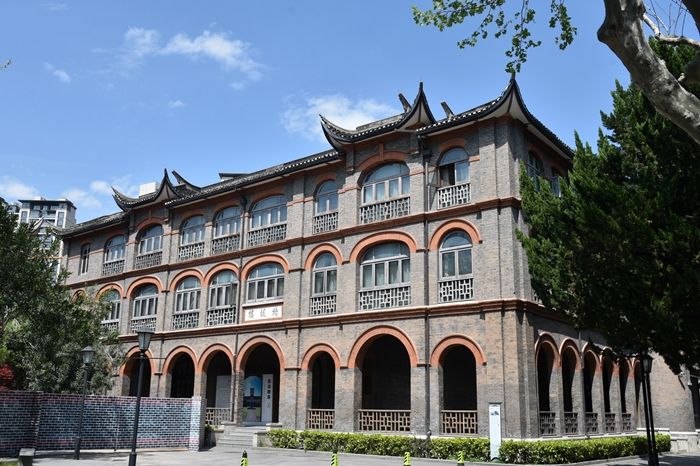
    这次正好离我们住的环球港不远,就去了下圣约翰大学旧址——现在的华东政法大学。原来同事的太太就是这里毕业后和别人一起开的法律事务所,做得风生水起,很成功。

    相比有些大学,去华东政法大学参观,不用登记、预约,被不少媒体称为国内开放度最高的高校之一。

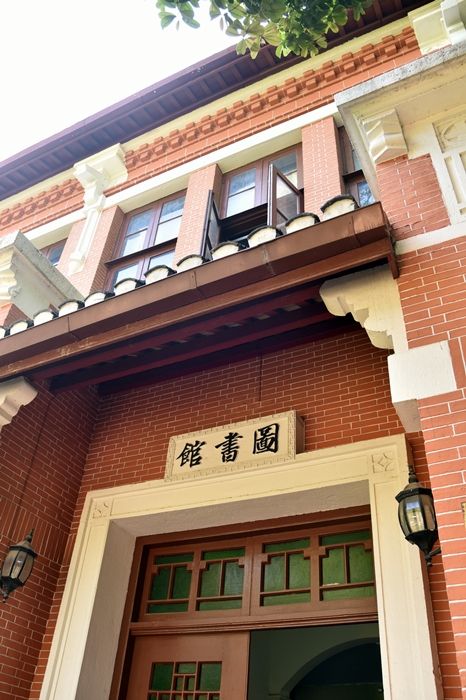
    走在中山北路校区一带,现在仍然很容易感受到那段老上海大学的气质残影。大片草坪、红砖楼、拱形窗、略带西式哥特风格的建筑线条,让人很难把它和现代都市大学完全等同起来,它更像一段被保存下来的历史章节。这里被人们称为上海最适合拍照的大学。

    高大的法国梧桐把道路遮成一条条绿色隧道,阳光从叶片缝隙洒下来,落在旧建筑的墙面上,形成一种很安静的斑驳感。

    走到一些旧建筑附近,你会注意到墙面修复过,但仍尽量保留原来的风格;窗框不新,但结构依旧稳固。

    29a1599390346E9fAcqh.jpg

    圣约翰大学由圣公会所属1865年成立的培雅书院和1866年成立的度恩书院于1879年合并而成,名为圣约翰书院(St. John’s College),后改名为圣约翰大学(St. John’s University)。该校在1892年起开设大学课程,是中国历史上第一所大学。建校比老爸的天津大学(北洋大学堂)和北京大学(京师大学堂)都要早一些。创建时,还没有中国高校的代表北大与清华,可见其历史悠久。

    最近正好在看何冰演的电视剧《江海潮生》,讲的是清朝状元,企业家,教育家张謇创办通州师范学校(中国第一所师范学校),复旦公学(现复旦大学前身),国立东南大学(现南京大学,东南大学等)等一系列高等学府的故事,颇为感慨。
    29a159939114hxUXCMtr.jpg

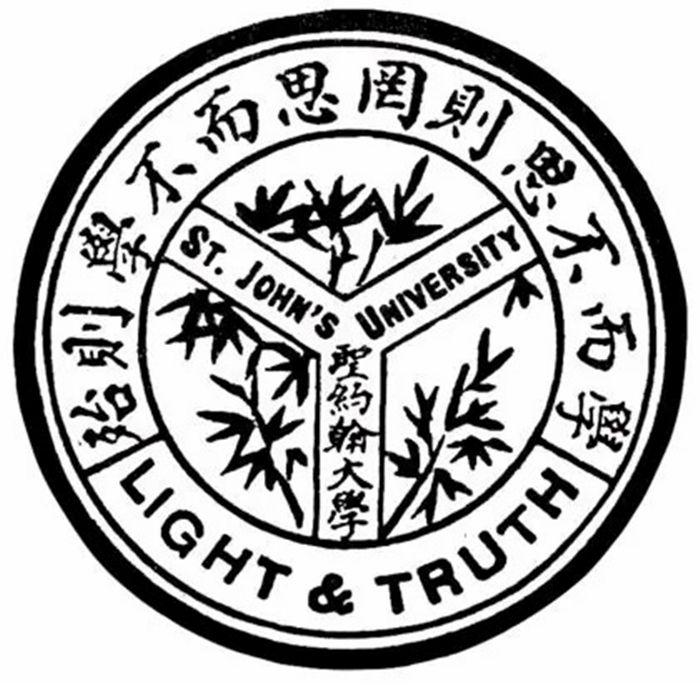
    圣约翰的校训是“Light and Truth”(光与真理),校刊称:“我们要使圣约翰大学成为中国之光和真理的火炬,没有再目标更崇高的了。” 可以说,中国的大学教育开始于教会大学,而教会大学则开始于圣约翰大学。

    所谓的与国际接轨的问题,圣约翰大学在100年前就实施了。 20世纪上半叶,圣约翰大学几乎是中国最早、也是最彻底实行英语教学的大学之一。从课程设置、教材选择到教学方式,基本都是直接对标欧美大学。相比之下,当时的北京大学、清华大学虽然也积极吸收西方教育理念,但整体走的还是中西融合的路线,不像圣约翰那样高度西化。
    29a159939078B45YPBAt.jpg
    圣约翰大学的学科逐渐完善,尤其是商科、法学、医学等应用领域实力突出,在上海这个国际化城市中占据重要位置,培养出大量通晓英语、熟悉西方制度的精英人才。1913年起圣约翰大学开始招收研究生,1936年起开始招收女生。
    29a159939069RE6D4BiK.jpg
    在抗日战争期间,虽然学校运作受到冲击,但仍尽力维持教学。

    抗战结束后短暂恢复教学。1949年,圣约翰大学设有文、理、医、工、农、神6个学院及附属中学,是当时中国最全面的综合性大学。当年的社会声望非常高,不少人甚至把它称为“中国第一大学”。

    1949年中国中央政府变更后,在1952年全国高校院系调整中,圣约翰大学难逃厄运地被拆分,其院系并入其他高校体系(如复旦大学、上海交大、华东政法等大学),从此不再作为独立大学存在,一个名校不复存在。

    圣约翰不仅是当时中国最著名的大学之一,也是职业导向非常鲜明的高等学府。它的毕业生在社会上很受欢迎,尤其是在上海这样的国际都市。无论是外资企业、银行、航运、法律还是外交领域,都有不少圣约翰校友,许多人后来还出国深造。培养了一大批在近代中国政界、商界、学界和文化界有影响力的人物。注重培养实务型人才和职业精英,对近代中国社会产生了深远影响。

    29a159939016YfHzLnwk.jpg
    下面是一些有代表性的校友:

    顾维钧: 近代中国最著名的外交家之一,参加巴黎和会、长期活跃于国际舞台,是典型的圣约翰式精英。

    宋子文: 民国财政与外交核心人物之一,历任国民政府财政部长、中央银行总裁、行政院长、中国银行董事长等等。是宋氏家族的重要成员 。他在任财政部长时被授予了圣约翰大学法学博士学位。

    贝聿铭: 世界级建筑大师。

    林语堂: 著名作家、学者,把中国文化介绍到西方世界的重要人物之一。

    邹韬奋: 新闻出版界的重要人物,对近代中国公共舆论有很大影响。

    颜福庆: 中国现代医学教育的重要奠基人之一,与圣约翰医学院体系密切相关。

    张伯苓: 教育家、体育活动家及政治人物。南开大学、南开中学的创始人,西南联大创始人,中华全国体育协进会理事长、中华民国考试院院长。

    荣毅仁: 企业家,曾担任中华人民共和国副主席,被称为“红色资本家”。

    严家淦:中华民国财经专家、曾任中华民国经济部部长、财政部部长、行政院院长,副总统,和总统。

    LD有个亲戚是无锡唐氏家族成员,40年代末毕业于上海圣约翰大学,毕业后进入上海一家外资洋行工作,原本前途一片光明。但1952年圣约翰大学停办后,他便很少再提起自己的母校。到了文革时期,更是处处低调谨慎,所幸没有受到太大的冲击。只是由于时代的变迁,终究未能充分施展自己的才华,聪明才智没有在事业上得到应有的发挥,有些令人惋惜。不过,与圣约翰大学历史上第一位中国校长涂羽卿在“三反”“五反”、反右和文革中遭受的精神与肉体的双重折磨,最终被迫害致精神失常、含恨离世的命运相比,他还是幸运的。。。。。。


  • AI-optimized documentation files
    A admin
    前沿技术&Advanced Technology

    As more users discover products through LLM-powered search, companies like Vercel, Anthropic, Supabase, and Windsurf are seeing meaningful traffic driven by AI tools. An llms.txt file provides structured instructions that help these systems index and interact with your site, making that discovery possible

    Companies breaking through AI-driven discovery have implemented an llms.txt file. Vercel reports that 10% of new signups now come from ChatGPT, and teams like Anthropic, Supabase, and Windsurf see users finding their products through LLM-powered search.

    An llms.txt file gives AI systems structured guidance on how to index and interact with your site, making this kind of discovery possible. Making your documentation discoverable to AI tools like ChatGPT, Claude, and Perplexity doesn’t need to soak up hours of manual work. By pasting your documentation URL into our free llms.txt generator, you’ll get a properly formatted starter file based on your structure in seconds—no signup required.

    Get started with your llms.txt now

    This guide walks through what the generator creates, why llms.txt matters for AI-driven growth, and three approaches to generating and maintaining your llms.txt file.
    What this llms.txt generator creates

    Our free llms.txt generator analyzes your documentation structure and creates a lightweight Markdown file optimized for LLM consumption.

    The tool outputs AI-optimized documentation with your site title, a blockquote summary, organized content sections, and key page links with descriptions. This structure follows the llms.txt format specification while making it easy for you to customize based on your documentation specifications.

    Example llms.txt

    Think of it as a starting template. The generator handles the formatting and structure, giving you a foundation you can refine to match exactly how you want AI tools to understand and present your product.
    Manual vs automatic llms.txt generation

    Creating an llms.txt file manually gives you full control over the content and structure, which is useful for highly customized documentation. However, that process is time-consuming and error-prone, especially for large or frequently updated docs.

    Our automatic llms.txt generator simplifies this process by analyzing your existing documentation and generating a compliant file in seconds. You get a correctly structured, AI-ready llms.txt file without worrying about formatting or missing metadata, while still having the flexibility to tweak it manually if needed.
    Why llms.txt matters for AI discoverability

    As AI-powered search becomes a common way for developers to find tools, having documentation that LLMs can read is critical. Vercel went from less than 1% to 10% of signups coming from ChatGPT in six months. That represents thousands of developers receiving accurate answers from an AI assistant based on Vercel’s documentation and converting to paid customers.

    When Anthropic asked us at Mintlify to implement llms.txt for our documentation, it reinforced what we were seeing across our customer base: AI assistants are becoming a primary discovery channel for technical products. To test our hypothesis, we’ve tracked LLM crawler behavior and observed consistent traffic from ChatGPT, Claude, and Perplexity crawlers accessing llms.txt files multiple times per week.

    This matters for your documentation because AI needs structured, accurate information to provide the right answer to users. Without llms.txt, the AI might pull from outdated Stack Overflow threads, competitor documentation, or even hallucinate an answer entirely.

    An llms.txt file creates a direct line between your documentation and the AI tools your users rely on. It directs LLMs to read the right complex HTML files and marketing-heavy pages.
    Three ways to generate llms.txt files

    You’ve got a few solid options for creating and maintaining your llms.txt file, depending on your team’s size, resources, and how much hands-on control you want. For a full comparison of platforms and plugins that support llms.txt, see our best llms.txt platforms guide.
    Use an llms.txt generator

    Best for: Small documentation sites, teams getting started with llms.txt, or anyone who wants immediate results without writing code.

    How it works: Use our free llms.txt generator tool to create your initial file. Paste in your docs URL, download the generated template, customize the sections and descriptions, and host it at your root domain.

    Benefits:

    No technical setup required
    Get started quickly
    Full control over content and structure
    Works with any hosting platform
    

    Tradeoffs: When you add new pages or restructure your docs, you’ll need to update the llms.txt file manually. For documentation that changes frequently, this can become a maintenance burden.
    Script-based automation (DIY approach)

    Best for: Engineering teams comfortable with scripting, documentation sites with frequent updates, or teams wanting automated updates without committing to a platform.

    How it works: If you’re already running build scripts or CI/CD pipelines for your documentation, you can integrate llms.txt generation directly into that workflow. A build script reads your documentation structure and outputs a formatted file on each deploy.

    Example script-based automation

    This works well with static site generators like Docusaurus, Next.js, or VitePress, where you can hook into the build process.

    Benefits:

    Automatically stays in sync with your docs
    Full control over generation logic
    No ongoing manual updates
    

    Tradeoffs: Requires engineering effort to build and maintain. Generation logic must be updated as your docs evolve.
    Platform-native automation

    Best for: Teams who want zero-maintenance AI optimization, documentation platforms handling multiple products, or companies treating docs as a strategic growth channel.

    How it works: By using Mintlify’s built-in llms.txt generator, every time you publish documentation changes, the platform regenerates your llms.txt file — along with llms-full.txt and markdown variants optimized for different AI use cases.

    Benefits:

    No scripts or configuration to maintain
    Always stays in sync with live documentation
    Supports multiple AI-optimized formats out of the box
    

    Tradeoffs:

    Requires using a documentation platform
    Less low-level control than a fully custom script, however Mintlify customers are able to override the generated llms.txt with manual updates If you're in high-growth mode and documentation is becoming a user discovery channel, this approach removes llms.txt from your maintenance burden entirely — freeing up engineering time to build products instead of maintaining doc infrastructure.
    

    How to implement your llms.txt file

    Once you’ve generated your file using any of the methods above, you need to make it accessible to AI tools. Here’s the implementation process:

    Step 1: Save your file as plain markdown Name it exactly llms.txt—no .md extension or alternate naming. The file should contain only Markdown-formatted text.

    Step 2: Place it at your root domain Host the file at yourdomain.com/llms.txt, similar to how robots.txt and sitemap.xml work. AI tools expect to find it at this standard location.

    Step 3: Ensure it serves as plain text The file should render as raw Markdown, not wrapped in HTML. If you’re using a static site generator, configure your public folder or routes to expose the file directly.

    Step 4: Handle subdomain documentation If your docs live at docs.yourdomain.com or yourdomain.com/docs, you can also host the file at that subpath (e.g., /docs/llms.txt).

    Step 5: Verify accessibility Navigate to your llms.txt URL in a browser. You should see plain Markdown text, not a 404 or HTML-wrapped version.
    Choosing your llms.txt approach

    The right generation method depends on your documentation maintenance pattern and how aggressively you’re pursuing AI-driven discovery.

    Choose the manual llms.txt generator if you have a small documentation site that doesn’t change frequently, or if you’re just getting started with AI optimization and want the simplest path forward. You can create your llms.txt file quickly and start capturing AI search traffic almost immediately.

    Choose script-based automation if you already have build pipelines in place, your documentation updates regularly, and your team has the engineering bandwidth to maintain generation scripts. This gives you control while eliminating manual updates.

    Choose platform-native automation if you want AI optimization handled automatically, you’re managing documentation at scale, or you’d rather invest engineering time in your product than documentation infrastructure. This is the zero-maintenance option.

    ![why-businesses-hire-virtual-assistants-key-benefits-and-trends.webp](文件类型 .webp 无效。允许的类型为: .png, .jpg, .bmp, .txt, .mp4, .mp3, .jpeg) Whether you’re using our free llms.txt generator or automating with scripts, implementing llms.txt is one of the most effective ways to improve how AI tools surface and represent your product. The question isn’t whether to do it, but how quickly you can get it live.

    Already using Mintlify? Your llms.txt files are automatically generated and hosted.

    Not using Mintlify yet? Learn more about maintaining documentation that stays AI-optimized by default.

    Looking beyond llms.txt? Model Context Protocol (MCP) servers represent the next evolution of AI-native documentation, enabling even deeper integration with AI assistants.A_futuristic_representation_of_the_workplace_in_an-1-e1733228879805-1200x676.jpg

  • 出席DNC夏季会议侧记
    丹奇丹 丹奇
    美华之音 &Voice of Chinese American

    DNC 里程碑之旅

    罗玲博士 (2026年8月15日)

    2472.jpeg

    本周参加了8月12日到15日在德州奥斯汀举行的 2026年民主党全国委员会夏季会议(DNC Summer Meeting)。作为连任两届 DNC老年委员会理事,很高兴再次与来自全美各地的DNC领导人、民选官员以及各委员会的同事们相聚交流。

    FullSizeRender.jpeg

    会议第一天安排了密集的各党团和委员会会议。在 亚太裔党团(AAPI Caucus)会议上,主席 Bel Leong-Hong 回顾了自己九年来担任主席的历程,并准备将接力棒交给新一代年轻的亚太裔领导团队。她呼吁亚太裔社区继续团结起来,坚持争取我们的代表权,让亚太裔的声音得到更多关注和倾听。老太太下周八十岁,仍然中气十足。在DNC主席倡议下全场为她唱起生日快乐🎂令人感动😹

    德州众议员、德州众议院民主党党团主席 Gene Wu(吴元之) 也应邀在多个会议上发言,特别谈到当前亚太裔社区面临的挑战,呼吁大家更加重视亚太裔的政治参与、社区权益和代表性。
    IMG_4679.jpeg
    新任 DNC主席 Ken Martin 也在会议期间与大家分享了民主党未来的工作方向以及2026年中期选举面临的任务和挑战。
    IMG_4681.jpeg
    第二天参加了DNC组织的多项培训,包括社交媒体信息传播、跨社区参与以及联盟建设策略。在社区参与和联盟建设培训中,我也与参会者分享了我们在德州组织亚太裔社区应对 SB147土地限制法案的实际经验。面对一个影响多个亚太裔族群共同利益的问题,我们推动不同族裔和社区组织走到一起,建立联盟、协调行动、共同发声,让更多社区成员参与公共政策讨论。这段经历也成为一个很好的案例,让我有机会与来自其他州的参会者交流如何围绕共同关切建立跨社区联盟。

    2474.jpeg 2473.jpeg
    会议期间,我还与 DNC老年委员会主席 Richard Fiesta 、副主席 John Bauman (图七)以及其他理事一起参加了美国《社会保障法》签署91周年纪念活动。1935年8月14日,富兰克林·罗斯福总统签署《社会保障法》,对美国社会保障制度产生了深远影响。

    Live_20260814163319675.jpeg
    国会议员 Lloyd Doggett也受邀参加了老年委员会庆典并发表讲话。他推动法案在医保卡上免除社安号以保护个人信息免被泄漏。

    IMG_4772.jpeg
    最令人兴奋的是荣幸见到罗斯福总统的孙子、现任DNC规则与章程委员会共同主席 James Roosevelt Jr.。很高兴有机会与James Roosevelt Jr.见面交谈。罗斯福总统是把美国从大萧条中拯救出来的最伟大总统。他的公共服务理念和历史遗产,在家族后代中跨越几代继续传承,也让这次纪念活动多了一份特别的历史意义。

    两天的会议内容很多,从AAPI社区代表性、2026年中期选举,到社交媒体传播、社区参与、跨族裔联盟建设以及老年人权益,既有学习,也有交流和经验分享。很高兴再次见到许多老朋友,也认识了一些新朋友。一次充实的奥斯汀之行。

    IMG_4839.jpeg
    感谢DNC老年委员会理事会对我的信任,连续两届推荐我出任理事。也是唯一的亚裔理事。作为晚辈感觉自己肩上担子很重,有义务勇挑重担,除了照顾好他们,还要积极为全国老人们效劳。学习和了解《社会保障法》的历史背景对于将来推动Medicare 和保障老年人社会福利和权益意义重大。


  • 警醒:危险日益加剧,亚裔何去何从?
    美华之音美 美华之音
    美华之音 &Voice of Chinese American

    综合报道:从排斥到赋权——亚裔美国人正面临日益加剧的危险

    AADC 美华之音编辑部 林胥

    近年来,针对亚裔美国人的系统性攻击正在加速。得克萨斯州众议员、州众议院民主党领袖吴元之(Gene Wu)在其专题演讲《从排斥到赋权:所有亚裔美国人面临的危险日益增加》中,系统梳理了当前形势,并发出明确警告:如果我们不立即行动,历史极有可能重演。

    当前危险的核心事实
    新的反亚裔法律在过去5到10年内快速通过,且速度仍在加快。许多法案在几乎没有阻力的情况下获得通过,并使用巧妙的法律语言掩盖真实意图。

    最突出的威胁包括:
    • 外国人土地法(Alien Land Laws):禁止亚裔移民(包括签证持有者和部分绿卡持有者)拥有房屋、商业或农场。目前已有34个州通过了某种版本。得克萨斯州曾于1891年通过、1965年废除,却在2025年再次通过。
    • 就业与学术黑名单:多州限制或禁止中国籍人员在州立大学、政府及研究机构就业;限制中文执照考试;甚至出现根据护照限制AI使用的联邦政策。
    • H-1B与学生签证打击:国会已有议案主张直接终结H-1B项目;特朗普政府计划将学生签证期限限制在四年,需反复申请延期。
    • 针对中国学生的入学限制:得州、佛罗里达、印第安纳、伊利诺伊等地出现不同程度的限制或政治压力,联邦层面亦有先例。
    • 合同与采购禁令:多州禁止中国企业参与州政府合同,无人机、电信设备等被列入黑名单;联邦层面亦出现针对亚裔非营利组织资助的削减。
    • 出生公民权与公职资格:行政命令试图挑战第14修正案,并有州提出限制移民公民担任地方和州级公职。
    • 仇恨与基于种族/宗教的起诉:反南亚裔仇恨事件上升、“中国倡议”导致大量华人学者职业生涯被毁、针对伊斯兰中心的调查等,均显示攻击正在扩大。
    吴议员强调:针对一个社区的成功攻击,将来会被用来对付其他社区。 这些措施的本质,是关闭亚裔进入并留在美国的通道。

    历史正在重演

    美国曾在1882年至1965年间,通过《排华法案》及其后续措施,禁止亚洲人入境长达83年。经济竞争与“他们抢走我们的机会”的叙事,是当年排华的主要借口。今天,同样的语言与逻辑再次出现——针对亚裔成功、学业表现和财富积累的焦虑,正在转化为法律武器。
    吴议员指出,当前的“穆斯林禁令”在功能上与《排华法案》高度相似;而针对亚裔的土地法、就业限制与签证打压,正是历史模式的现代版本。

    我们能做什么?——行动的典范

    得克萨斯州曾在2023年成功击败外国人土地法相关法案(SB 147),成为唯一成功阻止相关版本通过的州。经验证明,以下三步有效:

    1. 教育:召开市政厅、虚拟会议,与族裔媒体沟通,让社区真正了解危险。
    2. 组织:建立邮件列表、社交媒体群组与短信网络。
    3. 动员:选民登记、游行抗议、直接联系民选官员。
      吴议员反复强调:沉默不是保护。 “模范少数族裔”的标签从未真正保护过我们;财富与公民身份也无法自动免疫——二战期间被关进集中营的日裔美国人中,约三分之二是在美国出生的公民。

    吴元之议员的呼吁:
    “我的家族来自广州,最终定居在休斯顿的Sharpstown。现在被推动的法律——禁止像我这样的家庭拥有房产、挑战出生公民权——正是针对我成长的社区。”

    “我们以前做到过,我们还能再做到!胜利触手可及。我们知道如何获胜,我们已经证明这是可以做到的。超越党派,只问一个问题:他们是朋友,还是敌人?”
    他特别提醒:不要幻想“我两边都捐款”“我是公民”“我有钱可以离开”就能置身事外。当对方认为你的存在威胁到他们的未来时,金钱买不到安全。

    立即行动:参加每周虚拟市政厅会议 (Town Hall)
    州众议员吴元之(Gene Wu)正在举办AAPI专题虚拟市政厅会议,每周日晚讨论反亚裔政策威胁、过往成功经验以及具体行动方案,并开放提问。

    时间:每周日晚上 7:00 – 8:00(中部时间) 形式:Zoom线上会议 报名与获取个人入会链接(一次报名即可参加系列活动):

    https://genefortexas.com/events 或直接访问: https://genefortexas.com/events/town-hall-with-rep-gene-wu

    请立即注册,邀请家人、朋友与社区伙伴一起参加。只有当我们团结起来、公开发声、持续行动,才能阻止历史重演,从排斥走向真正的赋权。

    现在就是行动的时刻。 团结一致,反抗不公。我们一起,可以改变这一切。

    请观看中英文视频, 并积极订阅美华之音频道,分享给更多亚裔美国人。

    您的浏览器不支持 HTML5 视频。 您的浏览器不支持 HTML5 视频。

  • 【丹奇杂谈】 家有儿女之--儿大不由娘
    丹奇丹 丹奇
    文学之窗 Literature Window

    (前言: 喜讯,被黑掉多年的汉纳老网站今天被抢救回来了。很幸运,近一千篇日志还在。大喜。遂随便点击一篇, 儿大不由娘,写于2018年。如今儿女已成年。女儿曾经威胁老妈要跑得远远的。果然就跑到了大不列颠。儿子也跑到驱车四小时多的达拉斯上大学。文章中的预言正在实现中。回顾过去,展望未来,岁月就是这样在来回一眨眼间倏忽而过。今日重发此文,以飨读者。)

    fdd3af5f36fc.jpg

    【丹奇杂谈】 家有儿女之–儿大不由娘

    丹奇 (2018年4月23日星期一)

    已是凌晨,人静。
    两只狗蜷伏在儿子的床头床脚守护着玩累了一天已经进入梦境的小主人。
    猫咪们各自占领一席自己舒适的角落,高低不同萌态各异地打着呼噜在梦中嬉戏。
    他爹有早睡早起的习惯,九点不到也去梦周公了。最近他再次蒙受脚痛风的折磨,便尽情享受着孩子他娘的尽心伺候。
    不时还要听从女儿的娇声请求“妈咪给我按摩!”而屁颠屁颠地奔向女儿床头,等把女儿送进梦乡后,终于消停,白天忙碌了一天后,又开启我的夜间工作模式。

    两个孩子,从小散养。忙碌如我,几乎没有精力陪他们玩耍,养成了他们自由散漫的性子,好在读书很自觉,成绩也不错。老妈便做了甩手掌柜,把一切交给党!不,交给学校。孩子们性格善良,爱心泛滥。只要宠物商店Petsco 有的宠物基本养了一个遍:小金鱼,蛇,老鼠,兔子,鸟,猫和狗就不用说了。可是,宠物们养着养着,孩子们耐心不足经验不够,除了猫狗,其他宠物基本都后天夭折,我们的后花园就成了宠物陵园,老妈有点像巴黎圣母院的老神父,承担起诵经祝祷送宠物们进天堂的任务。孩子们自然是经历从开始的万分悲痛到接受现实,继而喜新忘旧,再把满腹的爱心献给新宠的过程。如此循环往复,儿女们便在观察体验生命的轮回中成长起来。

    孩子们自从来到这个世上,便如洒向田野间的种子,在散养的熏风中,扑扑楞楞地长得飞快。一不小心,都超过了为娘的个头。想起多年前,孩子们降生时,曾经憧憬过,等他们长大了,带着他们回老家,一定会让他们的外婆很自豪好骄傲。瞧,小帅哥小美女,我的外孙们!伤痛的是,他们的外公外婆没能等到这一天。虽然从小培养了他们每逢二老生辰忌日节日,都能在老妈的督促下为外公外婆上香祝祷,仍然期待着哪年清明节孩子们能放假,我可以带他们回老家祭祖寻根,让外公外婆看看。

    然而,随着孩子们的一天天长大,很多愿望便成为一场场的拉力赛。一头绳子牵在我的手里,另一头在他们的叛逆期和文化差异之间。于是,小时候听说过的“儿大不由娘”的老话,终于有了深刻体会。从前,一家人逛商店,孩子们喜欢一手拉着妈妈,一手拉着爸爸,让我们高高地吊起来往前起跳着飞跑。那时,累并快乐着。听着他们欢喜地咯咯声,心里是浓情蜜意。

    不知道从几年级开始,女儿宁愿让同学妈妈开车送她们去看电影逛商店,也不要自己的妈妈送。理由是,妈妈说话方式不入她的法眼,让她感觉丢人。老妈暗自委屈不满@#¥%……&%……¥#(此处省去二十个字)实在没办法需要老妈接送了,女儿用挑剔审视的眼光,把老妈的衣着批评一番,这件太落伍,那件太土气。在掌上明珠面前,在外彪悍的老妈便有些无所适从,干脆一件白衬衫,一条牛子裤,经典装备,如何?女儿这才点头认可,好,可以出发!好在女儿已度过逆反期,不再与老妈为敌。一颗忐忑之心刚要放下,马上又进入了儿子逆反期。这是轮流上阵,不让老娘歇口气的节奏啊。

    儿子从小是为娘最心疼的宝贝,因为说话太晚,三岁时,口齿不清,经常说不清要喝什么吃什么,让为娘干着急,担心这孩子长大是哑巴。进入幼儿园时,儿子孤单落寞独坐一隅不合群的情景让躲在教室窗帘后观察不忍离去的老妈心痛泪落。至今仍然定格在记忆中,成为心中永远的歉疚。

    后来送他进了特殊语言班,在老师的帮助下,儿子勇敢地接受挑战,最后能顺利发出几个困扰了大家很久的发音。儿子是聪慧的,二年级开始,已经变得伶牙俐齿,学习成绩稳中上升,最后捧回许多奖状,让爹娘悬着的心终于放下。儿子也成为我们小区街道上的孩子王。喜欢动手折纸,速玩魔方,然后各种玩具的升级换代,单车摩托车滑板,各种猎枪,能从商店买到的品种基本都满足。儿子如今已经不再碰其他玩具,而是沉迷在电脑游戏中。自己曾经很腼腆地告诉老妈,他玩游戏的水平已经进入全球前列。咱也也不懂他说的那些游戏分类和级别。庆幸的是,儿子很自律。做完作业后练习长号,然后才去玩游戏,玩够了游戏还会出去与同学一起打篮球。按时睡觉起床上学。然后不时i漫不经心地扔给妈妈几张100分或者90几分的考卷,让老妈一个人窃喜。

    渐渐地,儿子开始窜个子,十三岁已经超过爹妈的个头。从前睡觉都要妈妈抱着才能睡着的宝贝疙瘩蛋,现在已经独立,不但不让妈妈亲,更不让妈妈抱。偶尔在家时,还会以耍赖的姿态在老妈膝头撒娇,为娘立刻心领神会自己的钱包要大出血了。果然,儿子很狡猾,以退为攻的策略每每奏效。“我知道妈妈不会同意,我还是不说了!”“到底想要什么,快说!” 老妈的好奇心被吊足了胃口后,儿子仍然是先自我否定 “我知道你不会同意的。还是算了。” 于是,老妈先答应下来,果然价钱不菲。后悔来不及。谁叫你承诺了呢,在儿子面前需要守信用。于是,换来儿子一个熊抱“Thank you Mommy!” 为娘的心便融化了:”Mommy Loves you, My baby!" 仿佛回到孩子的童年时期。

    但是好景不常有,大多数时候,正在长出粗壮骨骼的儿子,也开始排斥为娘的亲昵行为,有时候想揽着儿子的肩膀一起逛商店也会被儿子很不客气地甩开,嘟囔着“要是给同学看到,多不好意思啊”。老妈便很伤心地开始自怨自艾,在尴尬中收起心中的落寞,知道儿子在长大的同时,也在与老妈渐行渐远。总有一天会展翅高飞,飞出老妈的视线。想想我们自己不就是这么飞离了我们父母的视线,飞到遥远的国度,把一双老人丢在了身后吗?老父亲老母亲曾经追随着女儿的脚印,尽力陪伴着单飞的女儿,直到再也迈不动他们年老的脚步,便化作一缕轻烟,洒向人间,飞翔在美中两地,笼罩着守护着他们的子孙后代。这是怎样的轮回,这又是怎样代代相传的宿命。

    女儿逆反时,曾经“恶狠狠”地说过,我只要一满18岁,就搬出去自己住,离开你们远远的,省得一天到晚听你们唠叨。逆反过后,女儿不再说这样令人伤心的狠话。可是,前天第一次,当我要求儿子周末把被两只狗仔拖得乱七八糟的房间收拾干净后,一贯善于整理自己房间的儿子居然调侃说,这不是我的房子,我以后自己住公寓,我一定会收拾得干净整洁。老妈听完,很震惊,为啥儿子说我们的家不是他的房子?他也开始想着要自由了吗?突然这颗心又开始忐忑起来。忙说,你知道住公寓得靠你自己赚钱支付房租哦,放在自己的家不住,妈妈不会给你钱住公寓的。儿子很自信地说,他会自己赚钱。咱心里五百个不同意,却又一千个偷着乐,儿子有志气!

    这是过得啥日子?孩子们小的时候,盼着他们快快长大。可是,半大小子的时候,老妈内心开始恐慌,不愿他们再疯长。他们每长大一岁,意味着离开父母的脚步又多迈出去一步。这些年,忙碌的脚步丈量了祖国的大江南北,美国的东西两岸,一则为公司,二则为公益,三则为政治,却没有时间陪在家人身边,突然间看到已经比我个子都要高的两个孩子,很有些恍惚,他们是谁?我的娃娃哪里去了?几年时间就这么一晃,犹如变戏法,把我的小娃娃们变成了小小少年。于是,开始手忙脚乱,想尽一切办法多和孩子们待在一起。

    这不,上周六,原定受邀参加德州民主党妇女颁奖大会。后来他爹提醒儿子所在的学校交响乐团周六要去San Antonio 参加州里比赛。他爹脚痛,没法开车,送儿子的任务我便承担下来,同时也可借机观摩儿子的比赛,三个多小时的车程,小意思。然而跟颁奖大会时间冲突。怎么办?这要是在中国,咱们的传统是大公无私,儿子的比赛可以忽略,一定不能耽误颁奖大会。受大公无私观念培养长大的我们,来到美国后,很不适应这里的国情。生病感冒带病上班却不受公司待见,大伙催着赶着让你回家休息,理由是不要传染给同事。还真是有道理,家里有人生病也是让你休假处理完后再去上班,以免忧烦操心影响工作。在美国,家庭是第一位的。其他都是次要的。于是为了儿子的比赛,咱向朋友抱歉不能参会。

    然而,正当老妈满腔热情准备送儿子上赛场时,被儿子兜头一盆凉水:他们全体乐团同学搭大巴去。不需要我送。同时儿子发牢骚,不希望我在那里拍照他们表演的情景。那样会让他在同学面前没面子。哎呀呀,臭小子,老妈的热情万丈被你浇灭了。得得得,咱不去。你好好玩。没有老妈在身边,自在,对吗?哼,果然是儿大不由娘!有点讪讪然。

    老妈便乐得又回去参加一年一度的颁奖大会。当晚抓紧上网订票。第二天便和一群妇女同志们度过了快乐的一天。回家途中,跑到九九大华大肆采购一周全家食用所需。然后,甩开膀子继续闹革命,写完当天活动的中英文报道分别发布在脸书推特微信等社交媒体后,已是夜深。儿子演出结束,回到学校已是午夜时分。揉揉疲惫的双眼,在蒙蒙细雨中,开车到学校接回儿子。

    “我们学校乐团这次在全州比赛中又拿了冠军!” 儿子坐在车上很淡然汇报了比赛成绩。老妈为儿子高兴,很兴奋,“真的? 太好了。有没有拍演出照?有没有人给你们录像? 有没有获奖照片?”媒体人的职业习惯,让老妈连着把几个问题连珠炮一般送给儿子。儿子又泼来一盆冷水 :” 演出禁止拍照录像呢。你想啥啊?” 老妈不甘心,这可是全州比赛诶,就这么着,啥影子都没留下?知道这样,还不如我去,至少用那个专业相机拉几个长镜头,至少为你们这些优秀的初中生留下一些光辉形象,日后留作纪念吧。

    哼,不高兴,不满意,不舍得!儿子成长过程的点滴他自己是不经意的。可是老妈都会认真收集。别说是这么大型的比赛获奖。就是过去这么些年平时孩子带回家揉得皱巴巴的试卷和学习资料,老妈都精心抹平,整整齐齐地收好装满了一个大纸箱,仿佛储存了儿女成长的记忆。我的母亲也是这么为我收藏我小时候的读书笔记和奖状的。母亲骄傲地炫耀我的三好学生奖状的情景又在脑海中闪现。想着自己这些一张纸都舍不得丢弃的行为,突然感悟,这就是传承。当娘的哪个不是如此心系子女,为他们成长过程中取得的任何一点成绩而自豪骄傲呢。

    可是,儿女渐渐长大,儿大终究不由娘。我要慢慢学会放手,做好准备习惯儿女即将挣脱缰绳,远离父母去追求自己的梦想,就像当初我自己从父母身边飞走,一直飞到大洋此岸,从此让思念模糊了父母年迈的身影,更模糊了两双牵挂的眼睛。这一幕终有一天在我们身上重演,这便是周而复始的人生之旅。

    嗨,儿大不由娘,娘可跟你去?

成员列表

rootbeerR rootbeer 群组所有者
58 帖子 -1 声望
湖畔农民湖 湖畔农民 群组所有者
22 帖子 0 声望
A admin 群组所有者
8 帖子 0 声望
jiemeraskyJ jiemerasky 群组所有者
35 帖子 0 声望
丹奇丹 丹奇 群组所有者
192 帖子 6 声望
  • 登录

  • 没有帐号? 注册

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 最新
  • 热门
  • 版块